Тестове на AI-інтегратора: Telegram-бот, n8n, Claude
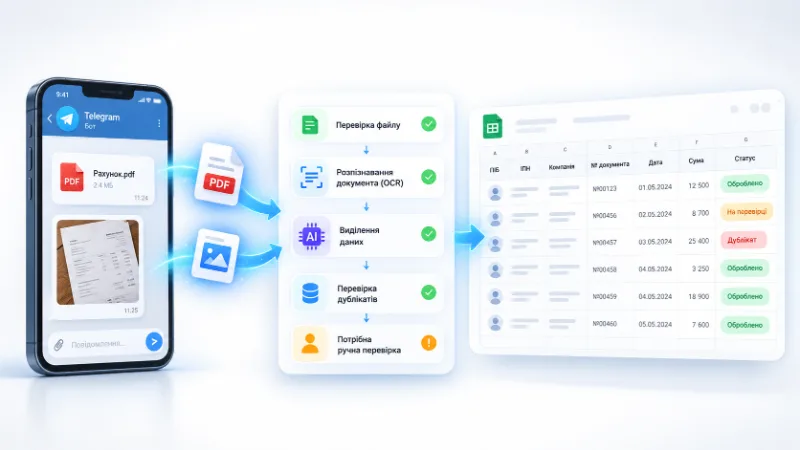
Одного разу мені надіслали тестове завдання на позицію AI-інтегратора. На перший погляд — цікаве: створити Telegram-бота, який приймає PDF або фотографію документа, розпізнає його через ШІ, витягує потрібні поля й автоматично записує результат у Google Sheets.
Але була одна деталь.
Це вже було не “напишіть маленьку функцію на годину”, а фактично готовий робочий workflow: Telegram, AI, документи, персональні дані, перевірка дублікатів, обробка помилок, база і демонстрація роботи.
І саме тому перша моя думка була не “класне тестове”, а: а де тут закінчується перевірка кандидата і починається безкоштовна розробка продукту?
Чому я взагалі погодився його робити
Причина виявилася доволі простою: мені самому було цікаво розібратися з n8n.
У своїй роботі я більше люблю програмні рішення — Pure JavaScript, Node.js, Google Apps Script. Там я бачу весь код, контролюю потік даних і точно розумію, що відбувається між входом і результатом.
А про n8n на той момент говорили буквально звідусіль. Тому я вирішив використати тестове не тільки як перевірку для роботодавця, а й як власний експеримент:
чи справді n8n настільки зручний, як про нього говорять?
Розгортати окремий сервер заради тестового не хотілося, тому я зареєструвався в n8n Cloud і використав тестовий період. Для знайомства з платформою цього було більш ніж достатньо.
Що виявилося всередині n8n
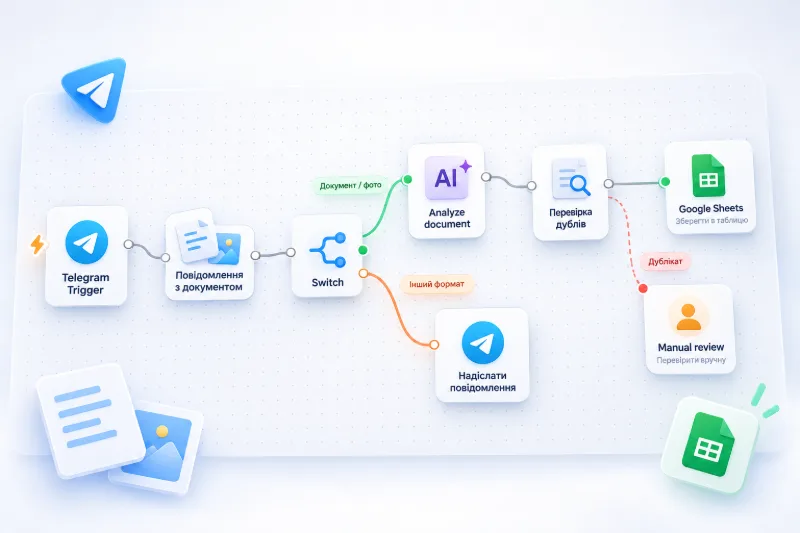
Якщо дуже спростити, n8n — це симпатичний візуальний редактор логіки.
Замість того щоб написати:
отримав файл → перевірив тип → перевірив дублікат → відправив у AI → перевірив результат → записав у таблицю
ви фізично складаєте цей ланцюжок із блоків.
Telegram Trigger.
Switch.
IF.
Google Sheets.
Anthropic.
Ще один IF.
Ще один Switch.
Для людини, яка тільки входить в автоматизацію, це справді зручно: можна буквально очима побачити, куди йдуть дані.
Але як розробнику мені досить швидко захотілося просто відкрити редактор і написати все кодом.
За моїм суб’єктивним відчуттям, аналогічний сценарій на Google Apps Script можна було б розкласти приблизно на три файли і близько 150 рядків коду. Це не benchmark і не точний замір — просто моя оцінка після складання того самого процесу у візуальному редакторі.
Яку архітектуру я в результаті зібрав
На вході був звичайний Telegram-бот.
Користувач надсилає:
- PDF;
- фотографію документа;
- або файл неправильного формату.
Далі workflow визначає, що саме прийшло.
Якщо формат не підтримується — користувач отримує нормальну відповідь із проханням надіслати PDF, JPG або PNG. Ніяких мовчазних падінь.
Після цього я додав перевірку fileuniqueid, щоб один і той самий документ не оброблявся повторно. Якщо файл уже проходив через систему, бот повідомляє, що документ був оброблений раніше.
І тільки після цієї перевірки файл іде далі в AI.
Чому я обрав Claude
Для самого розпізнавання я використав Anthropic API.
Завдання моделі було не просто “прочитай документ”, а повернути чітку структуру даних:
- тип документа;
- мову;
- ПІБ;
תעודת זהות/ ID;- назву компанії;
- номер документа;
- номер страхового поліса;
- дати;
- грошові суми;
- додаткові важливі поля.
Але найважливіша частина prompt була не в цих полях.
Найважливішим для мене було заборонити моделі вигадувати те, чого вона не бачить.
Найважливіша частина AI-системи — вміти сказати “я не знаю”
Одна з найбільших помилок у таких інтеграціях — зробити красиве демо, де AI завжди повертає заповнений JSON.
У реальному житті документ може бути:
- обрізаний;
- розмитий;
- сфотографований під кутом;
- неповний;
- з погано видимим номером;
- без одного з обов’язкових полів.
У моєму workflow для цього були окремі поля:
missingrequiredfields
uncertain_fields
needsmanualreview
review_reason
Якщо необхідне поле відсутнє, значення прочитане неоднозначно або модель не впевнена в суттєвих даних — документ не повинен “успішно пройти систему”.
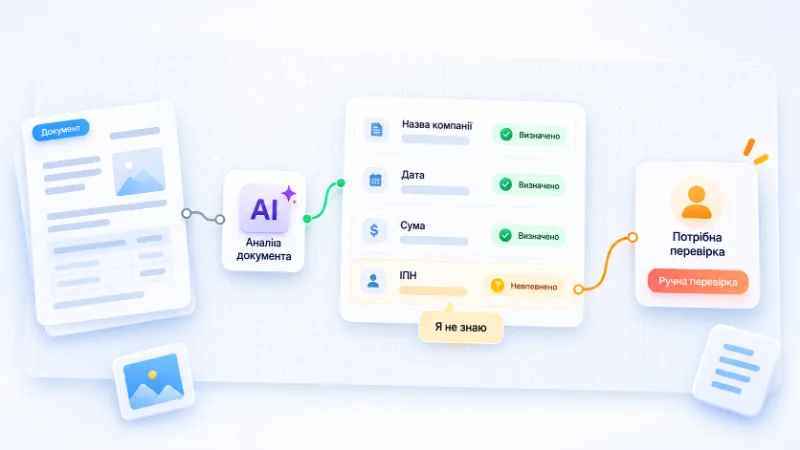
Він отримує статус ручної перевірки.
На мою думку, саме це відрізняє AI-інтеграцію від демки для LinkedIn: у продакшн-сценарії важливо не тільки правильно відповідати, а й правильно відмовлятися від відповіді.
Що відбувалося після AI
Відповідь моделі проходила ще один шар перевірки.
Якщо AI повернув некоректний JSON — workflow не намагався зробити вигляд, що все нормально. Такий сценарій отримував processing_error, а користувачу поверталося повідомлення про технічну помилку.
Якщо структура валідна — дані дописувалися в Google Sheets.
У таблицю потрапляли не тільки витягнуті дані документа, але й службова інформація:
- статус обробки;
- причина ручної перевірки;
- Telegram user ID;
- username;
- message ID;
- унікальний ID початкового файлу;
- ім’я файлу.
У результаті таблиця ставала не просто місцем зберігання розпізнаних значень, а невеликим журналом роботи всієї системи.
Реальний кейс автора: чого я насправді навчився з цього тестового
Найціннішим результатом для мене виявився навіть не сам Telegram-бот.
До цього завдання я дивився на n8n переважно з боку: популярний no-code/low-code інструмент, про який багато говорять у контексті AI-автоматизацій.
Після реальної збірки workflow стало набагато зрозуміліше, де його сила.
Для швидкого прототипу, інтеграції кількох сервісів або людини, яка не хоче одразу писати backend, n8n справді знижує поріг входу. За вечір можна візуально скласти досить серйозний процес і зрозуміти весь потік даних.
Але одночасно я зрозумів і інше: для складної логіки я все одно обрав би код.
Коли з’являється багато умов, повторне використання функцій, власна валідація, тестування, version control і нормальна робота з помилками, візуальний canvas для мене починає програвати звичайному JavaScript або Node.js.
Тобто тестове виконало для мене свою головну задачу: я отримав реальний досвід n8n і тепер розумію його не з YouTube-оглядів, а руками.
А що я в результаті віддав роботодавцю
І тут повертаємось до питання, з якого все почалося.
Я не вважаю правильною практикою передавати сторонній компанії повністю готовий production workflow із власними credentials, API-токенами та потенційно чутливими даними лише тому, що це назвали “тестовим завданням”.
Особливо коли система працює з документами, де можуть бути персональні дані.
Тому повний робочий варіант із моїми доступами залишився у мене.
Для демонстрації я підготував очищений workflow: без чутливих credentials, але з усією основною архітектурою, по якій можна оцінити моє рішення, логіку маршрутизації, AI-обробку, перевірку дублікатів і роботу з помилками.
На мій погляд, цього цілком достатньо, щоб перевірити компетенцію кандидата.
Де проходить межа нормального тестового
Я не проти тестових завдань.
Навпаки, хороше тестове часто розповідає про спеціаліста більше, ніж година стандартного інтерв’ю.
Але є проста різниця між:
“покажи, як ти мислиш”
і
“побудуй нам готовий продукт безкоштовно”.
Чим ближче завдання до другого варіанта, тим обережніше я б до нього ставився.
Особливо якщо в процесі вам пропонують працювати з реальними клієнтськими даними, production credentials або повністю передати результат після відбору.
Моє правило для тестових після цього кейсу
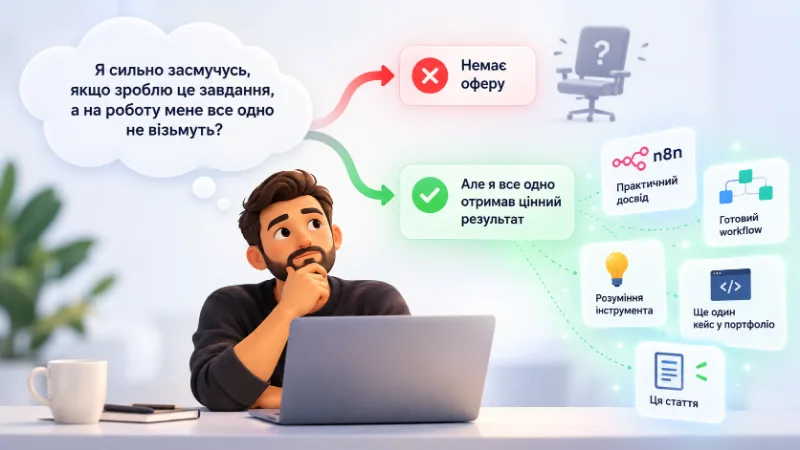
У мене залишилося дуже просте питання, яке я тепер раджу ставити собі перед великим тестовим:
“Я сильно засмучусь, якщо зроблю це завдання, а на роботу мене все одно не візьмуть?”
Якщо відповідь “так” — можливо, тестове просто не варте витраченого часу.
У моєму випадку відповідь була “ні”.
Навіть якби після цього не було жодної пропозиції, у мене залишилися:
- практичний досвід роботи з n8n;
- готовий Telegram Document AI workflow;
- розуміння сильних і слабких сторін visual automation;
- ще один AI-кейс у портфоліо;
- і, зрештою, ця стаття.
Тому для мене це тестове все одно окупилося.
І, мабуть, саме так я тепер дивлюся на подібні завдання: якщо після тестового цінність залишається не тільки у роботодавця, але й у вас — тоді його хоча б є сенс робити.
Останні статті
Автоматизація погодження документів у Google Drive: статуси, версії та журнал рішень
Файли final , final new і final v7_approved не показують погоджений документ. Автоматизація погодження документів керує станами, версіями й рішеннями. Для workflow доста…
Тестування AI-автоматизацій: як перевіряти prompts і не ламати результат після оновлення
Зміна в prompt може покращити JSON і зламати зміст. Модель повертає category , але губить примітку клієнта. Тому тестування AI автоматизацій має перевіряти формат і бізн…
Автоматизація комерційних пропозицій: як зібрати Google Docs, PDF і Gmail в один процес
У комерційній пропозиції більша частина роботи повторюється: підставити компанію, контакт, послуги, ціну, строк дії та менеджера. Тому автоматизація комерційних пропозиц…
Google Apps Script security: токени, права доступу і безпечні webhook-автоматизації
Google Apps Script security часто згадують тільки після того, як автоматизація вже працює. Таблиця приймає заявки, Web App отримує webhook-и, Telegram-бот відправляє пов…
OpenAI API cost control: як рахувати токени, ставити ліміти і не отримати несподіваний рахунок
OpenAI API cost control - це не страх перед LLM, а нормальна фінансова гігієна автоматизації. Якщо модель допомагає обробляти заявки, писати summary, класифікувати зверн…
Надійність автоматизації бізнес-процесів: черги, повтори і idempotency без великої інфраструктури
Надійність автоматизації бізнес-процесів починається не з Kubernetes, RabbitMQ або складної cloud-архітектури. У малому бізнесі вона часто починається з простішого питан…